NPU 硬件实现
本节结合 thu-cs-lab/cod-npu 仓库 rtl/sv/ 下的 SystemVerilog 代码,介绍 NPU 的硬件实现:PE、脉动阵列、L0A/L0B/L0C 片上存储,以及 LDTILE/TMUL 两条指令的控制逻辑。
PE 与脉动阵列
PE 具体实现
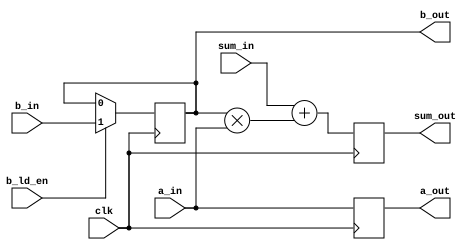
下面结合代码来讲解一下具体实现,PE 的实现源码就在 rtl/sv/pe.sv 当中,分析各部分功能如何对应到实现上:
首先,PE 模块设置了两个参数,允许设置不同的数据位宽:A_DW 代表输入数据位宽,也就是 A 和 B 矩阵的元素位宽。C_DW 代表输出数据位宽,也就是 C 矩阵的元素位宽。默认配置下,实现的是 int8 x int8 矩阵,结果累加到 int32,因此默认值就是 A_DW=8,C_DW=32。
接着,首先看 A 元素的处理,首先在模块端口上,设置 a_in 输入,获得来自左方 PE 的 A 元素,以及 a_out 输出,在 1 拍的延迟后,把 a_in 的值传给右方的 PE:
// A 元素:从左方 PE(或左边缘)流入,向右传播
input  wire signed [A_DW-1:0] a_in,    // 来自左方 PE(或左边缘)的 A 元素
output wire signed [A_DW-1:0] a_out,   // 传给右方 PE(1 拍延迟)
内部的逻辑也比较简单,就是设置一个寄存器,实现 A 元素从左到右的流动:
// A 元素右传寄存器:实现 A 元素从左到右的流动
reg signed [A_DW-1:0] a_out_reg;
always_ff @(posedge clk) begin
  if (rst) begin
    a_out_reg <= '0;
  end else begin
    a_out_reg <= a_in;              // A 向右流动,1 拍延迟
  end
end
assign a_out = a_out_reg;
接着是乘法和加法的部分,从上方流入部分和 sum_in,计算 sum_in + b_reg * a_in,其中 b_reg 保存的就是该 PE 对应的 B 矩阵的元素,计算结果打 1 拍后通过 sum_out 输出:
// 部分和:从上方 PE(或阵列顶部)流入,向下传播
input  wire signed [C_DW-1:0] sum_in,  // 来自上方 PE(或阵列顶部)的部分和
output wire signed [C_DW-1:0] sum_out  // 传给下方 PE
逻辑部分:
// B 元素寄存器
reg signed [A_DW-1:0] b_reg;

// 部分和寄存器:实现乘加运算,从上方流入 sum_in,计算 sum_in + b_reg * a_in 向下流动
reg signed [C_DW-1:0] sum_out_reg;
always_ff @(posedge clk) begin
  if (rst) begin
    sum_out_reg <= '0;
  end else begin
    // 乘加:sum_in + b_reg * a_in,1 拍延迟
    sum_out_reg <= sum_in + b_reg * a_in;
  end
end
assign sum_out = sum_out_reg;
最后是保存 B 矩阵元素的 b_reg 寄存器的相关逻辑,只需要在 b_ld_en 为真时,把从上方得到的 B 元素保存并向下传:
// B 元素寄存器:加载 B 矩阵元素期间(b_ld_en 为真)每拍写入 b_in,同时向下流动;
// 之后 b_ld_en 为 0,b_reg 保持不变
reg signed [A_DW-1:0] b_reg;
always_ff @(posedge clk) begin
  if (rst) begin
    b_reg <= '0;
  end else begin
    if (b_ld_en) b_reg <= b_in;     // 写入并向下流动
  end
end
assign b_out = b_reg;               // 向下传播
PE 单元的电路图如下(忽略了 rst 部分逻辑):
脉动阵列实现
有了 PE 以后,脉动阵列就是在 PE 的基础上,把 PE 之间连接起来:
- 计算矩阵乘时,A 矩阵的元素从左到右流动,那么左右相邻的 PE 里,左边 PE 输出的 a_out 接到右边 PE 输入的 a_in
- 计算矩阵乘时,部分和从上向下流动,那么上下相邻的 PE 里,上边 PE 输出的 sum_out 接到下边 PE 输入的 sum_in
- 加载 B 矩阵时,B 矩阵的元素也是从上向下流动,那么上下相邻的 PE 里,上边 PE 输出的 b_out 接到下边 PE 输入的 b_in
下面是对应的代码,在 rtl/sv/systolic_array.sv 里。首先是输入输出,对应脉动阵列左侧 A 矩阵的输入、顶部 B 矩阵的输入和底部 C 矩阵的输出:
module systolic_array #(
    parameter PE_N = 4,    // 阵列大小(N x N)
    parameter A_DW = 8,    // A/B 元素位宽
    parameter C_DW = 32    // C 元素位宽(部分和)
) (
    input  wire                        clk,
    input  wire                        rst,

    // B 元素:从顶部逐拍注入一行(LDTILE)
    input  wire                        b_ld_en,     // 写入使能
    input  wire signed [PE_N*A_DW-1:0] b_ld_data,   // 从顶部注入的一行 B

    // A 元素:从左边斜入(TMUL)
    input  wire signed [PE_N*A_DW-1:0] a_left,      // A[i][j] 在拍 i+j 从行 j 进入阵列

    // 部分和:从底部斜出(TMUL)
    output wire signed [PE_N*C_DW-1:0] sum_bottom   // C[i][j] 在拍 i+j+N 从列 j 离开阵列
);
首先例化 NxN 个 PE,把这些 PE 的信号都拉出来,这里用 generate 语法来批量生成 verilog 代码:
// 例化 N x N 个 PE
genvar i, j;
generate
  for (i = 0; i < PE_N; i++) begin : gen_row
    for (j = 0; j < PE_N; j++) begin : gen_col
      pe #(
          .A_DW  (A_DW),
          .C_DW  (C_DW)
      ) u_pe (
          .clk      (clk),
          .rst      (rst),
          .b_ld_en  (b_ld_en),
          .b_in     (pe_b_in[i][j]),
          .b_out    (pe_b_out[i][j]),
          .a_in     (pe_a_in[i][j]),
          .sum_in   (pe_sum_in[i][j]),
          .a_out    (pe_a_out[i][j]),
          .sum_out  (pe_sum_out[i][j])
      );
    end
  end
endgenerate
接下来,完成 PE 之间的连线。对于 B 矩阵,从顶部注入 b_ld_data,然后逐行向下流动:
// B 矩阵
// 第 0 行 PE 从顶部注入 b_ld_data 数据用于 LDTILE
for (genvar j = 0; j < PE_N; j++) begin : gen_b_top
  assign pe_b_in[0][j] = b_ld_data[j*A_DW +: A_DW];
end
// 从第 i 行 PE 向下传播 B 元素到第 i+1 行 PE
for (genvar i = 1; i < PE_N; i++) begin : gen_b_mid
  for (genvar j = 0; j < PE_N; j++) begin : gen_b_mid_j
    assign pe_b_in[i][j] = pe_b_out[i-1][j];
  end
end
对于 A 矩阵,从左边缘注入 a_left,然后逐列向右流动:
// A 矩阵
// 第 0 列 PE 注入 a_left 数据用于 TMUL
for (genvar i = 0; i < PE_N; i++) begin : gen_a_left
  assign pe_a_in[i][0] = a_left[i*A_DW +: A_DW];
end
// 从第 i 列 PE 向右传播 A 元素到第 i+1 列 PE
for (genvar j = 1; j < PE_N; j++) begin : gen_a_mid
  for (genvar i = 0; i < PE_N; i++) begin : gen_a_mid_i
    assign pe_a_in[i][j] = pe_a_out[i][j-1];
  end
end
对于部分和,从顶部注入零,然后逐行向下流动,C 矩阵结果会从最后一行 PE 输出:
// 部分和
// 第 0 行,顶部恒为零
for (genvar j = 0; j < PE_N; j++) begin : gen_sum_top
  assign pe_sum_in[0][j] = '0;
end
// 第 i 行 PE 向下传播部分和到 第 i+1 行 PE
for (genvar i = 1; i < PE_N; i++) begin : gen_sum_mid
  for (genvar j = 0; j < PE_N; j++) begin : gen_sum_mid_j
    assign pe_sum_in[i][j] = pe_sum_out[i-1][j];
  end
end

// 底部从最后一行 PE 输出
for (genvar j = 0; j < PE_N; j++) begin : gen_sum_bottom
  assign sum_bottom[j*C_DW +: C_DW] = pe_sum_out[PE_N-1][j];
end
可见脉动阵列的结构非常简单,只有连线,没有额外的寄存器,因此脉动阵列可以把大部分面积用在 PE 内部的计算(乘法器和加法器)上。到这里,你就已经完成了一个 4x4 的脉动阵列,可以实现矩阵乘法。实际上,这个设计高度参考了 Google 第一代 TPU 的论文(2017 发表在 arXiv:1704.04760),只不过 TPU 的脉动阵列直接做到了 256x256 的规模。
但单纯一个脉动阵列还不够:还没有处理斜入斜出,没有解决数据从哪里来、到哪里去的问题,也没有能和 CPU 接起来。接下来就来解决,数据的搬运,以及和 CPU 的集成。
控制逻辑与片上存储
理解了 NPU 上数据是怎么流动之后,就知道脉动阵列外围的 NPU 逻辑都需要做什么了。下面结合代码来进行学习。
控制逻辑
控制逻辑实现在 npu_core 模块当中,这个模块做了这些事情:
- 例化了在上文已经设计好的脉动阵列 systolic_array 模块
- 例化了 L0A/L0B/L0C 三个片上存储,使用 FPGA 的 BlockRAM 实现
- 实现两个状态机,分别负责 LDTILE 和 TMUL 指令的执行
- 针对 LDTILE:状态机驱动 L0B 的读取端口,在 N+1 拍内把 L0B 读取出的数据填入脉动阵列
- 针对 TMUL:状态机驱动 L0A 的读取端口,把读取后的数据经过若干个移位寄存器,斜入脉动阵列的左边缘,同时在脉动阵列的底部斜出,通过移位寄存器把 C 矩阵的同一行数据同步起来,从 L0C 读取旧值,累加后把新值写入 L0C
- 针对 CPU:允许 CPU 通过 MMIO 方式通过 Wishbone 总线,把数据写入 L0A/L0B,再把数据从 L0C 读出
下面结合 rtl/sv/npu_core.sv 的源码对各部分实现进行解析。
例化脉动阵列
首先,npu_core 模块例化了 systolic_array 模块,并把对应的输入输出信号引了出来:
// ============ 脉动阵列 ============
wire [PE_N*8-1:0]   a_left;       // A 左边缘(斜入)
wire [PE_N*32-1:0]  sum_bottom;   // 底部部分和(C 斜出)
wire                b_ld_en;      // B 写入使能
wire [PE_N*8-1:0]   b_ld_data;    // 逆序从阵列顶部注入一行 B

systolic_array #(
    .PE_N  (PE_N),
    .A_DW  (8),
    .C_DW  (32)
) u_array (
    .clk       (clk),
    .rst       (rst),
    .b_ld_en   (b_ld_en),
    .b_ld_data (b_ld_data),
    .a_left    (a_left),
    .sum_bottom(sum_bottom)
);
脉动阵列的接口还是比较简单清晰的。
例化 L0A/L0B/L0C 片上存储
在 FPGA 上,L0A/L0B/L0C 被实现为双端口的 Simple Dual Port Block RAM,即它有两个端口,其中端口 A 用于写入,端口 B 用于读取,读取有一拍的延迟,这里把它封装为 blockram_1r1w 模块:
module blockram_1r1w #(
    parameter DEPTH  = 64,    // 深度
    parameter DATA_W = 32,    // 位宽
    localparam A_W = $clog2(DEPTH)
) (
    input  wire clk,
    input  wire rst,

    // 写端口 A
    input  wire                wea,
    input  wire [A_W-1:0]      addra,
    input  wire [DATA_W-1:0]   dina,

    // 读端口 B
    input  wire                enb,
    input  wire [A_W-1:0]      addrb,
    output wire [DATA_W-1:0]   doutb
);

  // 行为模型,与 BRAM 语义一致
  reg [DATA_W-1:0] mem [0:DEPTH-1];
  reg [DATA_W-1:0] doutb_reg;

  // 写:wea 时写入;读:enb 时下一拍输出
  always_ff @(posedge clk) begin
    if (wea) mem[addra] <= dina;
    if (enb) doutb_reg <= mem[addrb];
  end
  assign doutb = doutb_reg;

endmodule
对于写端口 A 来说,当 wea 为高时,往地址为 addra 的位置写入 dina 的数据;对于读端口 B 来说,当 enb 为高时,从地址为 addrb 的位置读取数据,1 拍的延迟后通过 doutb 输出。
Vivado 会识别这种实现,并把它用 Block RAM 来实现。接下来,例化 blockram_1r1w 来用于 L0A/L0B/L0C 片上存储:
// ============ L0A/L0B/L0C RAM ============
wire [L0A_DW-1:0] l0a_rdata;          // L0A 读数据(A 的一行,PE_N 个 int8)
wire [L0B_DW-1:0] l0b_rdata;          // L0B 读数据(B 的一行,PE_N 个 int8)
wire [L0C_DW-1:0] l0c_rdata;          // L0C 读数据(C 的一行,PE_N 个 int32)
wire          l0a_ren, l0b_ren, l0c_ren;
wire [L0A_AW-1:0] l0a_raddr;
wire [L0B_AW-1:0] l0b_raddr;
wire [L0C_AW-1:0] l0c_raddr, l0c_waddr;
wire          l0c_wen;
wire [L0C_DW-1:0] l0c_wdata;

blockram_1r1w #(.DEPTH(L0A_DEPTH), .DATA_W(L0A_DW)) u_l0a (
    .clk(clk), .rst(rst),
    .wea(aw_valid), .addra(aw_addr), .dina(aw_data),
    .enb(l0a_ren), .addrb(l0a_raddr), .doutb(l0a_rdata)
);

blockram_1r1w #(.DEPTH(L0B_DEPTH), .DATA_W(L0B_DW)) u_l0b (
    .clk(clk), .rst(rst),
    .wea(bw_valid), .addra(bw_addr), .dina(bw_data),
    .enb(l0b_ren), .addrb(l0b_raddr), .doutb(l0b_rdata)
);

blockram_1r1w #(.DEPTH(L0C_DEPTH), .DATA_W(L0C_DW)) u_l0c (
    .clk(clk), .rst(rst),
    .wea(l0c_wen), .addra(l0c_waddr), .dina(l0c_wdata),
    .enb(l0c_ren), .addrb(l0c_raddr), .doutb(l0c_rdata)
);
其中 L0A 和 L0B 的写口是给 CPU 上的软件用的,所以直接接到模块的输入上:
// L0A 写(软件),一次写入 A 的一行(PE_N 个 int8)
input  wire                   aw_valid,
input  wire [L0A_AW-1:0]      aw_addr,
input  wire [L0A_DW-1:0]      aw_data,
// L0B 写(软件),一次写入 B 的一行(PE_N 个 int8)
input  wire                   bw_valid,
input  wire [L0B_AW-1:0]      bw_addr,
input  wire [L0B_DW-1:0]      bw_data,
L0C 比较特殊,因为累加逻辑和 CPU 都需要读取 L0C,这部分逻辑留到后面来分析。
LDTILE 指令实现
为了实现 LDTILE 指令,首先要从 L0B 经过 N 拍读取出 B 矩阵,再用 N 拍把数据从顶部传入脉动阵列。由于 L0B 的读取有一拍的延迟,所以实际上需要 N+1 拍完成一次 LDTILE 指令,故状态机设计如下:
- 在 IDLE 状态下,等待来自 CPU 的指令;当 CPU 发起一条 LDTILE 指令时,计算出 B 矩阵最后一行的地址 ldtile_base + PE_N - 1 保存到 l0b_addr_reg 寄存器(其中 ldtile_base 是 LDTILE 指令的参数,代表要加载的 B 矩阵在 L0B 内的地址),同时转移到 LOAD 状态
- 在 LOAD 状态下,持续读取 L0B,同时通过 r_cnt 寄存器统计周期数:
- 当 r_cnt == 0 时,开始读 L0B(设置 l0b_ren 为 1),此时从 L0B 读取的地址就是 ldtile_base + PE_N - 1,同时 l0b_addr_reg 寄存器的值减一,开始读 B 矩阵的倒数第二行
- 当 1 <= r_cnt <= PE_N 时,已经有从 L0B 读取的数据,此时把读取的数据传入脉动阵列的 b_ld_data,同时设置 b_ld_en,也让 l0b_addr_reg 寄存器的值减一,逆序读取
- 特别地,当 r_cnt == PE_N 时,转移到 IDLE 状态,此时 LDTILE 指令执行完成
一种可能的波形如下,假设 ldtile_base 等于 4,B[4] 代表 L0B 地址为 4 内的数据(假设 L0B 有足够大的空间):
对应源码如下,首先是状态机和对应的状态转移逻辑:
// LDTILE 状态机
// 只有 LOAD 一个工作状态:注入 PE_N 拍后回到 IDLE。
localparam [1:0] LS_IDLE = 2'd0, LS_LOAD = 2'd1;
reg [1:0] ldtile_state;
reg [1:0] ldtile_state_next;      // 组合次态
always_ff @(posedge clk) begin
  if (rst) ldtile_state <= LS_IDLE;
  else     ldtile_state <= ldtile_state_next;
end

// LDTILE 拍号(范围是 0..PE_N):LS_IDLE 接受指令时清 0,LS_LOAD 内每拍 +1
localparam RCNT_W = $clog2(PE_N + 1);                         // LDTILE 拍号位宽
reg [RCNT_W-1:0]       r_cnt;                                 // LDTILE 拍号
always_ff @(posedge clk) begin
  if (rst) r_cnt <= '0;
  else if (ldtile_state == LS_IDLE && ldtile_valid) r_cnt <= '0;
  else if (ldtile_state == LS_LOAD)                 r_cnt <= r_cnt + 1;
end

// 次态:LDTILE 注入 PE_N 拍后完成(LS_LOAD 拍 0 发读、拍 1..PE_N 注入)
localparam [RCNT_W-1:0] LDTILE_LAST = RCNT_W'(PE_N);          // LDTILE 注入末拍(r_cnt 同宽)
always_comb begin
  ldtile_state_next = ldtile_state;
  case (ldtile_state)
    LS_IDLE: if (ldtile_valid) ldtile_state_next = LS_LOAD;
    LS_LOAD: if (r_cnt == LDTILE_LAST) ldtile_state_next = LS_IDLE;   // 注入 PE_N 拍(PE_N 行 B)
    default: ;
  endcase
end
然后根据状态和 r_cnt 的值,驱动 L0B 的读取,把读取结果 l0b_rdata 传给脉动阵列:
// 逆序读通过递减计数器实现:LDTILE 开始时计算 B 子块末行地址 ldtile_base + PE_N - 1,
// 装入 l0b_addr_reg 寄存器,之后每周期减一。
localparam L0B_LAST = PE_N - 1;               // 子块末行偏移
reg [L0B_AW-1:0] l0b_addr_reg;
always_ff @(posedge clk) begin
  if (rst) begin
    l0b_addr_reg <= '0;
  end else if (ldtile_state == LS_IDLE && ldtile_valid) begin
    l0b_addr_reg <= ldtile_base + L0B_LAST[L0B_AW-1:0];   // 装入子块末行地址
  end else if (ldtile_state == LS_LOAD) begin
    l0b_addr_reg <= l0b_addr_reg - 1;           // 每周期减一(逆序)
  end
end

assign l0b_ren    = (ldtile_state == LS_LOAD) && (r_cnt < LDTILE_LAST);
assign l0b_raddr  = l0b_addr_reg;
// b_ld_en 在注入期(拍 1..PE_N)都为真:PE 每拍写入 b_in(向下流动),最后一拍锁存自己的 B
assign b_ld_en    = (ldtile_state == LS_LOAD) && (r_cnt >= 1);
assign b_ld_data  = l0b_rdata;                                // 顶部注入一行 B
TMUL 指令实现
接下来是 TMUL 指令实现,回顾前面对脉动阵列的分析,每一拍要做的事情如下:
- 第 0 拍到第 M+N-2 拍:输入 A 矩阵,A 矩阵元素 A[i][j] 在第 i+j 拍从第 j 行 PE 进入阵列;
- 第 N 拍到第 M+2N-2 拍:输出 C 矩阵,C 矩阵元素 C[i][j] 在第 i+j+N 拍第 j 列 PE 离开阵列。
针对 L0A,要做的事情就是,从第 0 拍到第 M-1 拍,每拍出 A 矩阵的一行元素,由于 L0A 读取有一个周期的延迟,因此要提前一个周期把地址传入 L0A 进行读取。为此,给状态机设计一个额外的 PRE 状态,用于提前一个周期读取 L0A 中 A 矩阵的第 0 行元素,这样它就会在进行计算的 MUL 状态下的第 0 拍得到 A 矩阵的第 0 行元素的值。接着,为了把读出来的数据 l0a_rdata 斜入脉动阵列,把 A 矩阵的不同列接入对应延迟的移位寄存器(Shift Register),再把移位后的信号 a_cols 传入脉动阵列。
针对 L0C,要做的事情是,把脉动阵列输出的 C 矩阵元素 sum_bottom 经过一系列不同延迟的移位寄存器进行对齐,对齐后的信号 c_cols,就是从第 2N-1 拍到第 M+2N-2 拍每拍出一行的 C 矩阵,累加旧值后写入 L0C。考虑到累加需要读取旧值,而读取需要一个周期的延迟,于是从第 2N-2 拍到第 M+2N-3 拍读取 C 矩阵的旧值。
状态机设计为:IDLE 状态下,收到新的 TMUL 指令,转移到 PRE 状态,一个周期后转移到 MUL 状态,通过 t_cnt 计数器统计拍数,当 t_cnt == M+2N-2 时,计算完成,转移到 IDLE 状态。
设 M=N=4,那么 L0A 的读取就是第 0 拍到第 3 拍,L0C 的读取是第 6 拍到第 9 拍,L0C 的写入是第 7 拍到第 10 拍,下面给出一次计算的波形,其中 A[i] 代表 L0A 地址为 i 的数据,对应 A 矩阵的一行,Aij 代表 A 矩阵第 i 行第 j 列的元素:
首先是 L0A 的读取波形:
从 PRE 开始到 MUL 状态 t_cnt == 2 的四个周期,每个周期从 L0A 读取 A 矩阵的一行,然后通过移位寄存器,从 t_cnt == 0 到 t_cnt == 6 这 7 拍的时间把 A 矩阵斜入脉动阵列。
其次是 L0C 的读-改-写波形:
当 t_cnt == 4 时,脉动阵列底部的 sum_bottom 开始输出第一个元素,经过一系列移位寄存器对齐后,实际输出是 t_cnt == 7 到 t_cnt == 10 这四个周期,因此,提前一个周期,从 t_cnt == 6 到 t_cnt == 9 这四个周期读取 L0C 中的旧值,当旧值读取出来了,新的 c_cols 也计算出来了,此时就可以累加并写入 L0C。
对应代码如下,首先是状态机部分:
// PRE 1 拍(预取 A 第 0 行)-> MUL(M+2N-1 拍)-> IDLE。
localparam [2:0] TS_IDLE = 3'd0, TS_PRE = 3'd1, TS_MUL = 3'd2;
reg [2:0] tmul_state;
reg [2:0] tmul_state_next;
always_ff @(posedge clk) begin
  if (rst) tmul_state <= TS_IDLE;
  else     tmul_state <= tmul_state_next;
end

// TMUL 拍号(范围是 0..M+2N-2):TS_IDLE 接受指令时清 0,TS_MUL 内每拍 +1
localparam TCNT_W = $clog2(M_MAX + 2 * PE_N - 1);  // TMUL 拍号位宽(最多能数到 M_MAX+2N-2)
reg [TCNT_W-1:0]       t_cnt;                                 // TMUL 拍号
always_ff @(posedge clk) begin
  if (rst) t_cnt <= '0;
  else if (tmul_state == TS_IDLE && tmul_valid) t_cnt <= '0;
  else if (tmul_state == TS_MUL)                t_cnt <= t_cnt + 1;
end

// 次态:TMUL 在 t_cnt == m_m1+2*PE_N-1 时结束(最后一行 C 已写入,共 M+2*PE_N-1 拍)
localparam [TCNT_W-1:0] TMUL_LAST = TCNT_W'(2 * PE_N - 1);  // 最后一行 C 写出的拍号偏移(m_m1 + 2*PE_N-1)
always_comb begin
  tmul_state_next = tmul_state;
  case (tmul_state)
    TS_IDLE: if (tmul_valid) tmul_state_next = TS_PRE;
    TS_PRE:  tmul_state_next = TS_MUL;   // 1 拍预取(读第 0 行)后进入计算
    TS_MUL:  if (t_cnt == {{(TCNT_W-MM1_W){1'b0}}, m_m1} + TMUL_LAST) tmul_state_next = TS_IDLE;   // 最后一行 C 已写入
    default: ;
  endcase
end
这里用了一个常见的硬件小技巧:由于 M 不可能等于 0,并且 M 通常最大值取一个 2 的幂次,为了节省一点空间,就直接约定保存的是 M-1 而不是 M 本身,所以这里的 m 都带了 _m1 的后缀,表示 minus 1。
接下来是 L0A 的读取,首先在寄存器 l0a_addr_reg 中计算每一拍对 L0A 的读取地址并读取:
// L0A 地址用寄存器保存:指令开始时装入 a_base,之后每拍加一。
reg [L0A_AW-1:0] l0a_addr_reg;
always_ff @(posedge clk) begin
  if (rst) begin
    l0a_addr_reg <= '0;
  end else if (tmul_state == TS_IDLE && tmul_valid) begin
    l0a_addr_reg <= tmul_a_base;                // 装入 A 行块基址
  end else if (tmul_state == TS_PRE || tmul_state == TS_MUL) begin
    l0a_addr_reg <= l0a_addr_reg + 1;           // 每拍加一,读下一行
  end
end

assign l0a_ren   = (tmul_state == TS_PRE) ||    // 预取拍读第 0 行
                   ((tmul_state == TS_MUL) && (t_cnt + 1 <= m_m1));
assign l0a_raddr = l0a_addr_reg;
读取结果拆分成 int8 元素,然后经过移位寄存器实现斜入:
// A 的 PE_N 路 8bit 各经一个 shift_register(对行 k 的元素打 k 拍,行 0 打 0 拍直通),
// 打拍深度由 generate 按 PE_N 展开
wire [PE_N*8-1:0] a_cols;
genvar i;
generate
  for (i = 0; i < PE_N; i++) begin : gen_a_shift
    shift_register #(.DATA_W(8), .DEPTH(i)) u_sr_a (
        .clk(clk), .rst(rst),
        .din(l0a_rdata[i*8 +: 8]), .dout(a_cols[i*8 +: 8]));
  end
endgenerate

// A 矩阵从脉动阵列左侧斜入,从第 0 拍到第 M+N-2(即 m_m1+1+N-2)拍
localparam [TCNT_W-1:0] A_LAST    = TCNT_W'(PE_N - 1);  // 最后一个 A 元素进入的拍号偏移(m + PE_N-1)
assign a_left = (tmul_state == TS_MUL && t_cnt <= {{(TCNT_W-MM1_W){1'b0}}, m_m1} + A_LAST)
    ? a_cols
    : '0;
其中移位寄存器模块的实现在 shift_register.sv 当中,内部就是一系列的寄存器:
module shift_register #(
    parameter DATA_W = 32,   // 数据位宽
    parameter DEPTH   = 4    // 打拍数(寄存器个数,0 = 直通)
) (
    input  wire clk,
    input  wire rst,
    input  wire [DATA_W-1:0] din,
    output wire [DATA_W-1:0] dout
);

generate
  if (DEPTH == 0) begin : gen_direct
    assign dout = din;
  end else begin : gen_shift
    // DEPTH 级打拍寄存器链
    reg [DATA_W-1:0] regs [0:DEPTH-1];
    always_ff @(posedge clk) begin
      if (rst) begin
        for (int i = 0; i < DEPTH; i++) regs[i] <= '0;
      end else begin
        regs[0] <= din;
        for (int i = 1; i < DEPTH; i++) regs[i] <= regs[i-1];
      end
    end
    assign dout = regs[DEPTH-1];
  end
endgenerate

endmodule
最后来到 L0C 的处理部分,首先是对脉动阵列的输出 sum_bottom 进行移位寄存器以进行斜出的对齐:
// 阵列底部每拍斜出一个对角(C[i][j] 在拍 i+j+PE_N 出列 j);PE_N 列结果分别经过
// 一个 shift_register(对列 j 打 PE_N-1-j 拍,列 PE_N-1 打 0 拍直通)对齐后,
// 每拍得到一行 C(PE_N 个 int32),写入 L0C。
wire [PE_N*32-1:0] c_cols;
genvar j;
generate
  for (j = 0; j < PE_N; j++) begin : gen_c_shift
    shift_register #(.DATA_W(32), .DEPTH(PE_N-1-j)) u_sr_c (
        .clk(clk), .rst(rst),
        .din(sum_bottom[j*32 +: 32]), .dout(c_cols[j*32 +: 32]));
  end
endgenerate
接着,在寄存器里维护 L0C 的读取地址和写入地址,从 t_cnt == 2N-2 开始到 t_cnt == M+2N-3 读取 L0C,读完的下一个周期写 L0C:
// 从第 N 拍到第 M+2N-2 拍:阵列输出 C 矩阵的时间范围。
// 经过移位寄存器对齐后,实际写入是第 2N-1 拍到第 M+2N-2 拍,共 M 拍。
// 因此读取旧值的时间是第 2N-2 拍到第 M+2N-3 拍,比对应的写入早一拍。
localparam [TCNT_W-1:0] l0c_rdata_START = TCNT_W'(2 * PE_N - 2);  // L0C 读窗口起点(t_cnt 偏移)
reg [L0C_AW-1:0] l0c_raddr_reg;
reg [L0C_AW-1:0] l0c_waddr_reg;
always_ff @(posedge clk) begin
  if (rst) begin
    l0c_raddr_reg <= '0; l0c_waddr_reg <= '0;
  end else if (tmul_state == TS_IDLE && tmul_valid) begin
    l0c_raddr_reg <= tmul_c_base;                // 装入 C 行块基址(行 0 地址)
  end else if ((tmul_state == TS_MUL) && (t_cnt >= l0c_rdata_START) && (t_cnt <= {{(TCNT_W-MM1_W){1'b0}}, m_m1} + l0c_rdata_START)) begin
    l0c_raddr_reg <= l0c_raddr_reg + 1;         // 每拍加 1(连续存放),下一行
    l0c_waddr_reg <= l0c_raddr_reg;             // 下一拍写地址 = 本拍读地址
  end
end

// L0C 读端口仲裁(ready-valid):core 的 acc 读改写占用读端口(发读拍)时 cr_ready 拉低,
// CPU 读 L0C 挂起等待;acc 读改写的发读拍提前一拍(raddr = 下一拍写地址)
wire l0c_rdata_used = acc && (tmul_state == TS_MUL) && (t_cnt >= l0c_rdata_START) && (t_cnt <= {{(TCNT_W-MM1_W){1'b0}}, m_m1} + l0c_rdata_START);
// ready-valid 握手: 只有 valid & ready 同时为 1(握手 cr_hs)才真正读 CPU 地址。
// acc 读改写优先使用读端口,不因 CPU 请求而被打断。
wire cr_hs = cr_valid && cr_ready;              // ready-valid 握手
assign cr_ready  = !l0c_rdata_used;             // ready 只依赖端口空闲
assign l0c_ren   = l0c_rdata_used | cr_hs;      // acc 读改写或握手拍才发读
assign l0c_raddr = cr_hs ? cr_addr : l0c_raddr_reg;
assign l0c_waddr = l0c_waddr_reg;

localparam [TCNT_W-1:0] L0C_WR_START = TCNT_W'(2 * PE_N - 1);  // L0C 写窗口起点(t_cnt 偏移)
assign l0c_wen   = (tmul_state == TS_MUL) && (t_cnt >= L0C_WR_START) && (t_cnt <= {{(TCNT_W-MM1_W){1'b0}}, m_m1} + L0C_WR_START);
在读取 L0C 的时候,还需要考虑到 CPU 也需要读取 L0C,那就在 MUL 状态下让 CPU 等待,优先让累加逻辑读取。读取出数据后,最后只需要进行累加,再把累加的数据写入 L0C:
// 累加按 lane 独立相加
genvar k;
generate
  for (k = 0; k < PE_N; k++) begin : gen_l0c_lane
    assign l0c_wdata[k*32 +: 32] = acc
        ? (l0c_rdata[k*32 +: 32] + c_cols[k*32 +: 32])
        : c_cols[k*32 +: 32];
  end
endgenerate
模块层次
npu_top
├── npu_wb        Wishbone 从机、寄存器、MMIO 译码
└── npu_core      计算核心
    ├── blockram_1r1w x3   L0A / L0B / L0C
    ├── systolic_array
    │   └── pe x PE_N x PE_N
    └── shift_register x (2*PE_N)   斜入 / 斜出对齐
npu_core 内部两条状态机是理解整个设计的关键:
- LDTILE 状态机只有
IDLE和LOAD两个状态,LOAD持续 PE_N+1 拍:第 0 拍发 L0B 读请求,第 1..PE_N 拍把读出的 B 行从顶部注入阵列; - TMUL 状态机有
IDLE、PRE、MUL三个状态,PRE预取 A 的第 0 行,MUL持续 M+2N-1 拍,期间完成 A 的斜入、C 的斜出对齐、L0C 的读改写。
一个容易忽略的点是 L0C 的读端口仲裁:TMUL 在累加时需要先读 L0C 旧值,而 CPU 也可能同时通过 Wishbone 读 L0C。npu_core 用 ready-valid 握手(cr_ready)把读端口优先让给累加逻辑,CPU 的读请求会在 npu_wb 中挂起,等 core 空闲后再发读。细节见 Wishbone 接口与顶层。
完整代码见 cod-npu 仓库根目录下的 rtl/sv/ 目录。除了 SystemVerilog 版本,仓库还提供了 Chisel 版本供集成。